هل تساءلت يوما لماذا ينجح بعض خبراء السيو في فحص آلاف الصفحات خلال دقائق، بينما يقضي غيرهم أياما طويلة أمام جداول البيانات؟ الجواب يكمن في استخدام بايثون في تحسين محركات البحث، وهو التحول الذي نقل المهام المتكررة من العمل اليدوي المرهق إلى سكربتات ذكية تعمل بدقة وسرعة. لذلك أصبحت لغة بايثون (Python) من أهم المهارات التي يبحث عنها أصحاب المواقع والوكالات التسويقية، لأنها تمنحهم قدرة حقيقية على تحليل البيانات واتخاذ قرارات مبنية على أرقام واضحة.
ومن المهم أن نفهم أن تحسين محركات البحث (SEO) لم يعد مجرد اختيار كلمات مفتاحية وكتابة مقالات جيدة، بل صار مجالا يعتمد على كميات ضخمة من البيانات مثل نتائج الزحف، وتقارير الأداء، وبنية الروابط الداخلية. وفي المقابل، فإن الأدوات الجاهزة قد لا تغطي كل احتياجاتك الخاصة، وهنا تتفوق بايثون بمرونتها، إذ تسمح لك ببناء حلول مخصصة تناسب طبيعة موقعك وحجمه وأهدافك التسويقية. علاوة على ذلك، فإن سهولة تعلم اللغة وكثرة مكتباتها المجانية تجعلانها خيارا مثاليا حتى للمبتدئين.
في هذا الدليل المرجعي سنتعرف معا على مفهوم Python for SEO وأهميته، ثم نستعرض المهام والأدوات والمكتبات التي تحتاجها، ونتدرج بعد ذلك في خطوات التطبيق العملي مع أمثلة وأكواد جاهزة للتنفيذ. كما سنتناول السيو التقني وتحليل بيانات الزحف وتحليل المحتوى وأتمتة المهام، وسنقارن بين بايثون والأدوات الجاهزة، ونوضح حدود هذا الأسلوب بأمانة علمية. وبنهاية المقال ستمتلك تصورا متكاملا يمكنك البدء بتطبيقه فورا على موقعك أو مواقع عملائك.
جدول المحتويات
- ما المقصود باستخدام بايثون في تحسين محركات البحث؟
- ما أهمية بايثون في تحليل المواقع وتحسين ظهورها في نتائج البحث؟
- ما المهام التي يمكن تنفيذها باستخدام بايثون في تحسين محركات البحث؟
- ما الأدوات والمكتبات اللازمة في استخدام بايثون في تحسين محركات البحث؟
- كيفية استخدام بايثون في تحسين محركات البحث خطوة بخطوة
- كيف تستخدم بايثون في تحسين محركات البحث التقني (Technical SEO)؟
- استخدام بايثون في تحسين محركات البحث في تحليل بيانات زحف المواقع
- تحليل محتوى صفحات الويب باستخدام بايثون في تحسين محركات البحث
- أتمتة مهام تحسين محركات البحث باستخدام بايثون
- ما الفرق بين استخدام بايثون في تحسين محركات البحث وأدوات تحسين محركات البحث الجاهزة؟
- ما حدود استخدام بايثون في تحسين محركات البحث؟
- الأسئلة الشائعة حول استخدام بايثون في تحسين محركات البحث
- هل يجب تعلم البرمجة لاستخدام بايثون في تحسين محركات البحث؟
- هل يمكن استخدام بايثون مجانا لتحليل المواقع؟
- هل تستطيع بايثون استخراج بيانات نتائج بحث Google؟
- هل تساعد بايثون في اكتشاف مشكلات SEO التقني؟
- هل يمكن استخدام بايثون لتحليل بيانات Google Search Console؟
- هل يؤدي استخدام بايثون إلى تحسين ترتيب الموقع مباشرة؟
- الخاتمة
ما المقصود باستخدام بايثون في تحسين محركات البحث؟
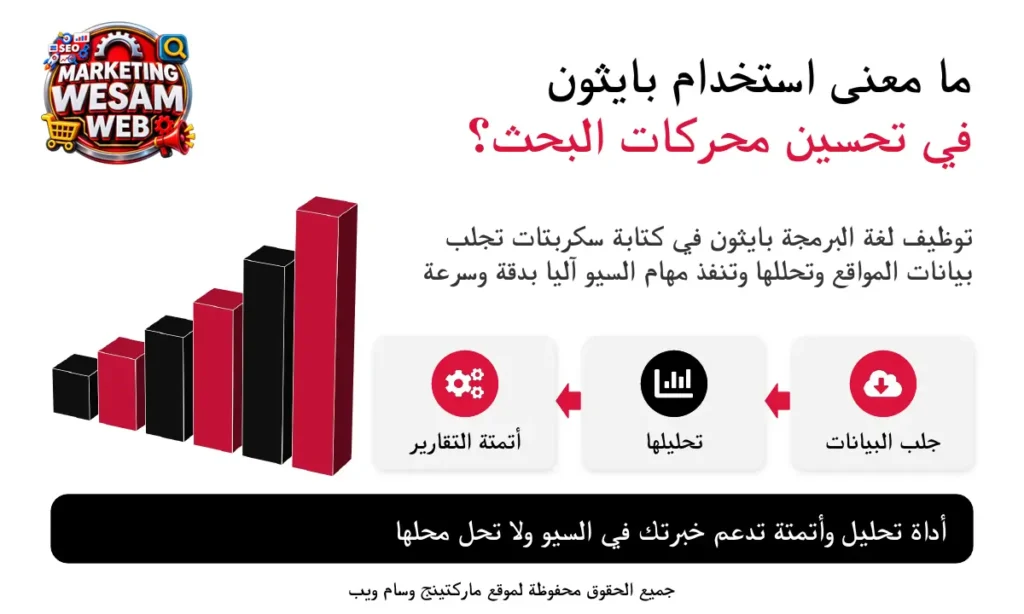
استخدام بايثون في تحسين محركات البحث يعني توظيف لغة البرمجة بايثون لكتابة سكربتات تنفذ مهام السيو بصورة آلية، مثل جلب بيانات الصفحات وتحليلها وفحص الأخطاء الفنية ومعالجة تقارير الأداء. وتتميز هذه اللغة بأنها مفتوحة المصدر وسهلة القراءة، كما يمكنك الاطلاع على التوثيق الرسمي للغة بايثون لفهم أساسياتها. ومن هنا جاءت تسمية Python for SEO للدلالة على هذا الدمج بين البرمجة والتسويق عبر محركات البحث.
ولا يعني هذا الأسلوب أنك ستتحول إلى مطور برمجيات، بل يعني أنك ستتعلم أجزاء محددة من اللغة تخدم عملك اليومي مباشرة. فعلى سبيل المثال، يمكنك كتابة سكربت قصير يزور مئات الصفحات ويستخرج عناوين الصفحات (Title) والأوصاف التعريفية (Meta Description) وعناوين H1 ورموز الاستجابة، ثم يحفظها في ملف منظم. وبالتالي توفر ساعات من العمل اليدوي، وتقلل احتمالات الخطأ البشري، وتحصل على بيانات قابلة للتحليل بدلا من ملاحظات متفرقة.
ومن ناحية أخرى، يرتبط هذا المفهوم ارتباطا وثيقا بإرشادات محركات البحث، إذ توضح وثائق Google Search Central المبادئ الأساسية التي يجب أن تلتزم بها المواقع. والسكربت الجيد لا يخدع محركات البحث ولا يتلاعب بالنتائج، وإنما يكشف المشكلات ويقترح الفرص لتطبق أنت التحسينات الصحيحة. لذلك ينبغي النظر إلى بايثون بوصفها أداة تحليل وأتمتة تدعم الخبرة البشرية ولا تحل محلها.
ما أهمية بايثون في تحليل المواقع وتحسين ظهورها في نتائج البحث؟
تكمن أهمية بايثون في قدرتها على التعامل مع حجم البيانات الكبير الذي يعجز عنه العمل اليدوي، فالموقع التجاري قد يضم عشرات الآلاف من الصفحات، وفحصها واحدة تلو الأخرى أمر غير عملي. ومن خلال الأتمتة يمكنك تحليل الموقع كاملا في وقت قصير، ثم التركيز على القرارات الاستراتيجية بدلا من استنزاف وقتك في المهام الروتينية. كما أن النتائج تكون قابلة للتكرار، أي يمكنك إعادة تشغيل السكربت نفسه كل أسبوع ومقارنة النتائج بدقة.
إضافة إلى ذلك، تمنحك بايثون مرونة كاملة في ربط مصادر بيانات مختلفة، كدمج نتائج الزحف مع بيانات الأداء من أدوات مشرفي المواقع، وهو أمر يصعب تحقيقه في الواجهات الجاهزة. ومن أبرز مزاياها العملية ما يلي:
- توفير الوقت والجهد عبر أتمتة المهام المتكررة مثل فحص الروابط وجمع الوسوم.
- تحليل البيانات الضخمة بسرعة باستخدام مكتبات متخصصة مثل Pandas.
- اكتشاف المشكلات التقنية مبكرا قبل أن تؤثر على الزحف والأرشفة.
- بناء تقارير مخصصة تناسب احتياجات العميل أو الإدارة.
- تقليل التكاليف لأن معظم المكتبات مجانية ومفتوحة المصدر.
- دعم القرارات المبنية على البيانات بدلا من التخمين والانطباعات الشخصية.
ما المهام التي يمكن تنفيذها باستخدام بايثون في تحسين محركات البحث؟
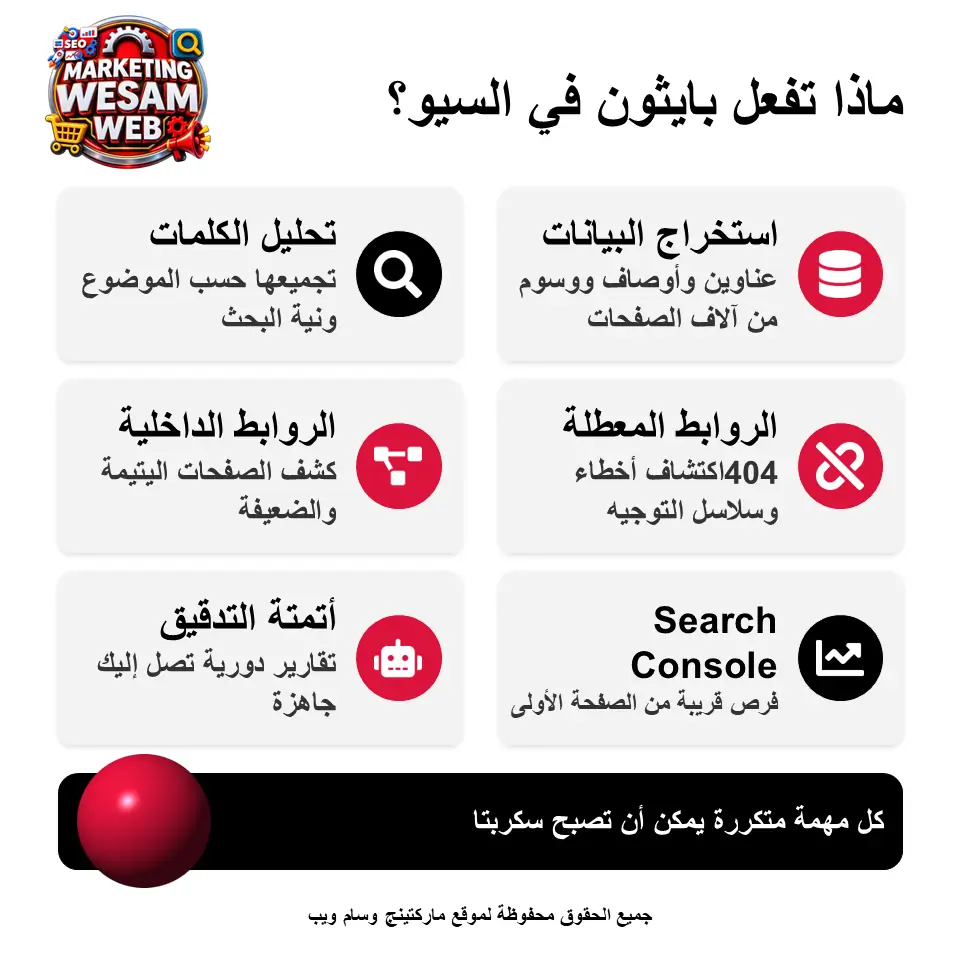
يغطي استخدام بايثون في تحسين محركات البحث طيفا واسعا من المهام، بدءا من جمع البيانات وانتهاء بـأتمتة التقارير، ولذلك من المفيد أن نلخصها في جدول واضح قبل أن نشرح كل مهمة بالتفصيل في الأقسام التالية. ويوضح الجدول أدناه أبرز المهام والهدف من كل منها والأدوات المناسبة لتنفيذها.
| المهمة | الهدف الرئيسي | الأداة المقترحة | الناتج المتوقع |
|---|---|---|---|
| استخراج بيانات الصفحات | جمع العناوين والوسوم والنصوص | Requests و Beautiful Soup | ملف منظم ببيانات الصفحات |
| تحليل الكلمات المفتاحية | تجميع الكلمات حسب الموضوع | Pandas | مجموعات موضوعية للكلمات |
| فحص الروابط المعطلة | اكتشاف أخطاء 404 و 5xx | Requests | قائمة بالروابط المكسورة |
| تحليل الروابط الداخلية | فهم بنية الموقع | Advertools و Pandas | خريطة روابط وصفحات يتيمة |
| تحليل Google Search Console | قراءة النقرات والظهور | Search Console API | تقارير أداء مخصصة |
| أتمتة التدقيق | تشغيل الفحوص دوريا | سكربتات مجدولة | تقارير دورية تلقائية |
استخراج بيانات صفحات الويب وتحليلها
تعد مهمة استخراج بيانات صفحات الويب (Web Scraping) من أكثر الاستخدامات شيوعا لبايثون في السيو، إذ يمكنك جلب العناوين والأوصاف ووسوم H1 وH2 وعدد الكلمات والروابط من أي صفحة بسرعة كبيرة. ويتم ذلك عبر إرسال طلب إلى الصفحة ثم تحليل شيفرة HTML المستلمة واستخراج العناصر المطلوبة. وبفضل هذه الطريقة تستطيع بناء قاعدة بيانات كاملة عن موقعك أو عن مواقع المنافسين في وقت قصير.
ومن الناحية العملية، يفيدك هذا التحليل في تدقيق عناصر الصفحة على نطاق واسع، فتكتشف الصفحات التي تفتقد وصفا تعريفيا، أو التي تحمل عنوانين متعددين من النوع H1، أو التي تتجاوز عناوينها الطول المناسب. كما يمكنك مقارنة بنية صفحاتك ببنية صفحات المنافسين لمعرفة الفجوات المحتملة. وبالتالي يتحول القرار من تخمين عام إلى إجراء محدد يستند إلى بيانات فعلية.
ومع ذلك، ينبغي الالتزام بالأخلاقيات المهنية عند استخراج البيانات، فاحترم دائما ملف robots.txt وشروط استخدام المواقع، وتجنب إرسال عدد كبير من الطلبات في وقت واحد حتى لا ترهق الخادم. ومن الأفضل أن تضيف فاصلا زمنيا بين الطلبات وتحدد هوية واضحة لسكربتك. إن هذا السلوك المسؤول يحمي سمعتك المهنية، ويضمن استمرار عملك دون حظر أو مشكلات قانونية.
تحليل الكلمات المفتاحية وتجميعها حسب الموضوع
يمثل تحليل الكلمات المفتاحية (Keyword Analysis) حجر الأساس في أي استراتيجية سيو ناجحة، ويساعدك استخدام بايثون في تحسين محركات البحث على معالجة قوائم ضخمة من الكلمات قد تصل إلى عشرات الآلاف في ثوان معدودة. فبدلا من فرز الكلمات يدويا داخل جدول إكسل، يمكنك تنظيفها وإزالة المكررات وحساب أطوالها وتكراراتها وتصنيفها آليا. ويمنحك ذلك رؤية واضحة للمواضيع التي تستحق التركيز عليها في خطة المحتوى.
أما تجميع الكلمات حسب الموضوع (Keyword Clustering) فهو خطوة متقدمة تربط الكلمات المتقاربة في المعنى ضمن مجموعات يمكن أن تستهدفها صفحة واحدة. وتعتمد هذه الطريقة على تحليل الكلمات المشتركة أو التشابه الدلالي أو تطابق نتائج البحث. ومن هنا تتجنب تضارب الصفحات على الكلمة نفسها، وتبني هيكلا منطقيا للمحتوى يخدم نية البحث (Search Intent) بصورة أدق.
وفضلا عن ذلك، يمكنك دمج بيانات الكلمات مع أحجام البحث ومستويات الصعوبة لتحديد الأولويات، فتبدأ بالفرص السهلة ذات العائد المرتفع. كما يتيح لك التحليل الآلي اكتشاف الكلمات الطويلة (Long Tail) التي تغفلها الأدوات التقليدية أحيانا. وبهذه الطريقة تبني خطة محتوى متماسكة، وتسهل لاحقا الربط الداخلي بين المقالات المرتبطة بالموضوع الواحد.
اكتشاف الروابط المعطلة وأخطاء الصفحات
تؤثر الروابط المعطلة (Broken Links) سلبا على تجربة المستخدم وعلى كفاءة زحف محركات البحث لموقعك، لأنها تقود الزائر إلى صفحات غير موجودة وتهدر ميزانية الزحف. ويمكن لسكربت بايثون بسيط أن يزور كل رابط في موقعك ويسجل رمز الاستجابة (HTTP Status Code) الخاص به. وبذلك تحصل على قائمة دقيقة بالروابط التي تحتاج إلى إصلاح أو إعادة توجيه.
ولا يقتصر الأمر على أخطاء 404، بل يشمل أيضا سلاسل إعادة التوجيه (Redirect Chains) وأخطاء الخادم من النوع 5xx والصفحات البطيئة في الاستجابة. ويساعدك السكربت على تصنيف هذه المشكلات حسب درجة الخطورة، فتبدأ بالأخطاء التي تصيب صفحات مهمة ومزارة كثيرا. ومن ثم تتحول عملية الفحص من مهمة مملة إلى عملية منهجية يمكن تكرارها بسهولة.
بالإضافة إلى ذلك، يمكنك ربط نتائج الفحص بعدد الروابط الداخلية والباك لينك التي تشير إلى الصفحة المعطلة لتحديد أثرها الحقيقي. فالصفحة المحذوفة التي تحصل على روابط خارجية قوية تستحق إعادة توجيه 301 إلى صفحة بديلة مناسبة. وهكذا تحافظ على قوة الروابط وتحمي ترتيبك في نتائج البحث من التراجع.
تحليل الروابط الداخلية وبنية الموقع
تشكل الروابط الداخلية (Internal Links) الشبكة التي تنقل قوة الصفحات وتساعد الزواحف على اكتشاف المحتوى، ولذلك فإن تحليلها يكشف الكثير عن صحة بنية الموقع. وتستطيع بايثون استخراج جميع الروابط من كل صفحة وبناء جدول يربط الصفحة المصدر بالصفحة الهدف ونص الرابط (Anchor Text). ومن هذا الجدول تبدأ رحلة فهم البنية الحقيقية لموقعك.
ومن أهم ما يكشفه هذا التحليل الصفحات اليتيمة (Orphan Pages) التي لا تتلقى أي رابط داخلي، وكذلك الصفحات المدفونة في عمق كبير يتطلب نقرات كثيرة للوصول إليها. كما يمكنك حساب عدد الروابط الواردة لكل صفحة وتحديد الصفحات الضعيفة التي تحتاج إلى دعم. وبالتالي تستطيع توجيه الروابط نحو الصفحات ذات الأولوية التجارية بصورة مدروسة.
كذلك يتيح لك التحليل الآلي مراجعة نصوص الروابط للتأكد من أنها وصفية وطبيعية وغير مكررة بصورة مفرطة. ويمكنك تمثيل البنية على شكل رسم شبكي لرؤية التجمعات والفجوات بوضوح. إن هذه الرؤية الشاملة تدعم استراتيجية الربط الداخلي وتحسن تجربة التنقل، وتفتح المجال لربط مقالاتك المستقبلية في السيو والتسويق والتجارة الإلكترونية والذكاء الاصطناعي.
تحليل بيانات Google Search Console
توفر أداة Google Search Console كنزا من البيانات حول النقرات ومرات الظهور ومعدل النقر ومتوسط الترتيب، لكن واجهتها تحدد حجم البيانات التي يمكن عرضها وتصديرها يدويا. وهنا تظهر قيمة بايثون، إذ تتيح لك سحب البيانات برمجيا وتحليلها على نطاق أوسع بكثير. ويمكنك الاطلاع على توثيق واجهة Search Console API لمعرفة إمكاناتها وحدودها.
ومن خلال التحليل البرمجي واستخدام بايثون في تحسين محركات البحث يمكنك اكتشاف الكلمات التي تظهر في المرتبة الثانية أو الثالثة صفحة، وهي فرص ذهبية لرفع الترتيب بتحسينات بسيطة في المحتوى. كما يمكنك رصد الصفحات التي تراجعت نقراتها مقارنة بفترة سابقة، وتحديد الاستعلامات ذات الظهور العالي ومعدل النقر المنخفض. وبذلك تعرف أين تحتاج إلى تحسين العناوين والأوصاف لجذب المزيد من النقرات.
علاوة على ذلك، يمكنك دمج بيانات Search Console مع نتائج الزحف لربط أداء الصفحة بحالتها الفنية، فتكتشف مثلا أن الصفحات الأقل أداء تعاني ضعفا في الروابط الداخلية. وهذا الدمج يحول التقارير الجامدة إلى رؤى قابلة للتنفيذ. ومن ثم تصبح قراراتك أكثر دقة، وتتمكن من قياس أثر التغييرات بوضوح عبر الزمن.
أتمتة عمليات تدقيق المواقع
يعتمد تدقيق المواقع (Site Audit) على فحص عشرات العناصر الفنية والمحتوائية، وإجراؤه يدويا في كل مرة يستهلك وقتا طويلا. أما مع الأتمتة فيمكنك دمج الفحوص في سكربت واحد يتحقق من رموز الاستجابة والعناوين والأوصاف والروابط والصور في تشغيل واحد. ويضمن ذلك اتساق المعايير بين مرة وأخرى، فلا يفوتك عنصر مهم بسبب النسيان أو الإرهاق.
كما يمكن جدولة السكربت ليعمل أسبوعيا أو شهريا ويرسل لك تقريرا جاهزا، وهو ما يسمح برصد المشكلات الجديدة فور ظهورها. ومن الفوائد المهمة أيضا إمكانية مقارنة نتيجة كل فحص بسابقه لقياس التقدم الفعلي في إصلاح المشكلات. وبالتالي يتحول التدقيق من مشروع مرهق يحدث مرة في السنة إلى عملية مستمرة تحمي موقعك على الدوام.
وفي سياق الوكالات، تمنحك الأتمتة ميزة تنافسية لأنها تتيح خدمة عدد أكبر من العملاء بالجودة نفسها وبتكلفة تشغيل أقل. ويمكنك تخصيص قوالب التقارير بحيث تعرض أهم الملاحظات بلغة مفهومة لأصحاب القرار غير التقنيين. ومن هنا تبرز بايثون بوصفها استثمارا ذكيا في مهاراتك المهنية يعود عليك بعوائد متراكمة مع الوقت.
ما الأدوات والمكتبات اللازمة في استخدام بايثون في تحسين محركات البحث؟
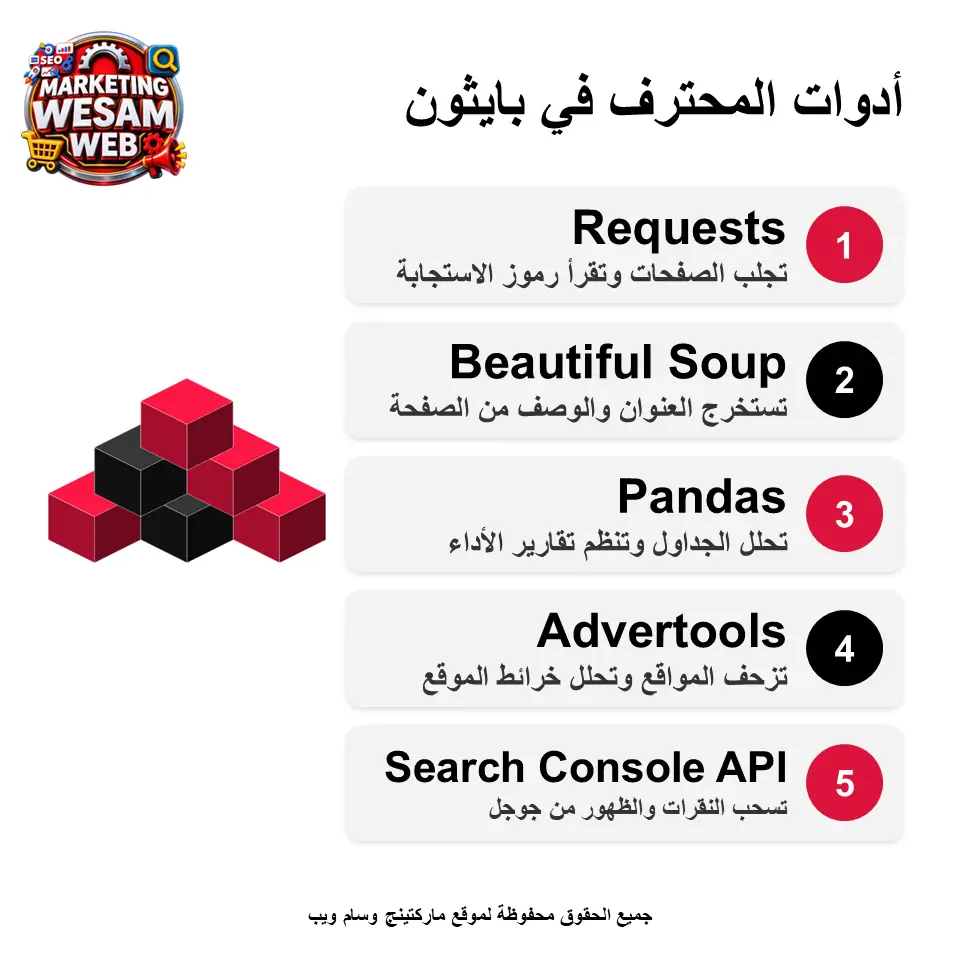
يعتمد استخدام بايثون في تحسين محركات البحث على مجموعة صغيرة من المكتبات المفتوحة المصدر التي تغطي معظم احتياجات المحترفين، ولا تحتاج إلى معرفة عميقة بالبرمجة لتبدأ بها. وتتكامل هذه المكتبات فيما بينها، فإحداها تجلب الصفحة، وأخرى تستخرج عناصرها، وثالثة تحلل النتائج وترتبها في جداول واضحة. ويلخص الجدول التالي أهم الأدوات ووظيفة كل واحدة منها ومتى تستخدمها، قبل أن نشرحها بالتفصيل مع أمثلة عملية.
| الأداة | الوظيفة الأساسية | أفضل استخدام في السيو | مستوى الصعوبة |
|---|---|---|---|
| Requests | جلب صفحات الويب وقراءة رموز الاستجابة | فحص الروابط والصفحات | سهل |
| Beautiful Soup | تحليل HTML واستخراج العناصر | استخراج العناوين والأوصاف | سهل |
| Pandas | تنظيم البيانات وتحليلها | تحليل الكلمات وتقارير الأداء | متوسط |
| Advertools | أدوات جاهزة للسيو والزحف | زحف المواقع وتحليل Sitemap | متوسط |
| Search Console API | سحب بيانات الأداء من Google | تحليل النقرات والظهور | متوسط |
مكتبة Requests لجلب بيانات صفحات الويب
تعد مكتبة Requests من أشهر مكتبات بايثون لإرسال طلبات HTTP، وهي الخطوة الأولى في أي سكربت يتعامل مع صفحات الويب. فهي تسمح لك بطلب أي رابط واستلام الشيفرة المصدرية للصفحة مع رمز الاستجابة (Status Code) والترويسات (Headers) وزمن الاستجابة. ولذلك تعتبر الأداة الأساسية لفحص الصفحات والتأكد من أنها تعمل كما ينبغي.
ومن ناحية عملية، يستفيد مختصو السيو من Requests في فحص الروابط والتحقق من إعادة التوجيه وقياس سرعة استجابة الخادم لعدد كبير من الصفحات. كما يمكنك إضافة ترويسة User-Agent تعرف بسكربتك، وتحديد مهلة زمنية (Timeout) حتى لا يتوقف السكربت عند صفحة بطيئة. وبهذه الإعدادات البسيطة يصبح الفحص أكثر أمانا واحترافية.
وفيما يلي مثال بسيط يوضح طريقة جلب صفحة وقراءة رمز استجابتها:
import requests

url = "https://example.com"
response = requests.get(url, timeout=10, headers={"User-Agent": "SEO-Audit-Bot"})

print(response.status_code)   # رمز الاستجابة مثل 200 أو 404
print(response.elapsed.total_seconds())  # زمن الاستجابة بالثواني
ويعطيك هذا المثال معلومتين أساسيتين عن أي صفحة، هما حالتها الفنية وسرعتها في الاستجابة، ويمكن تكراره على مئات الروابط بحلقة بسيطة.
مكتبة Beautiful Soup لاستخراج عناصر HTML
بعد جلب الصفحة بواسطة Requests تأتي مرحلة تحليل الشيفرة، وهنا تبرز مكتبة Beautiful Soup التي تحول نص HTML الخام إلى بنية منظمة يسهل البحث داخلها. فبدلا من التعامل مع آلاف الأسطر النصية، تستطيع طلب العنصر الذي تريده مباشرة، كالعنوان أو الوصف أو الروابط. وتعد هذه المكتبة الرفيق الدائم لمكتبة Requests في أغلب سكربتات السيو.
وتفيدك Beautiful Soup في استخراج عناصر السيو الأساسية مثل وسم title ووسم meta description وعناوين H1 وH2 ووسوم canonical والصور التي تفتقد النص البديل (Alt). وبالتالي تستطيع تدقيق الصفحة في ثوان ومعرفة العناصر الناقصة أو المكررة. كما أن المكتبة متسامحة مع الأخطاء الموجودة في شيفرة المواقع، وهو أمر شائع جدا في الواقع العملي.
والمثال التالي يستخرج عنوان الصفحة والوصف التعريفي وعدد وسوم H1:
import requests
from bs4 import BeautifulSoup

html = requests.get("https://example.com", timeout=10).text
soup = BeautifulSoup(html, "html.parser")

title = soup.title.string if soup.title else None
meta = soup.find("meta", attrs={"name": "description"})
description = meta["content"] if meta else None
h1_count = len(soup.find_all("h1"))

print(title, description, h1_count)
وهكذا تحصل على ملخص سريع لأهم عناصر الصفحة، ويمكنك توسيع المثال ليشمل بقية العناصر التي تهمك.
مكتبة Pandas لتحليل بيانات المواقع
تمثل مكتبة Pandas قلب تحليل البيانات في بايثون، فهي تحول القوائم والنتائج إلى جداول (DataFrame) تشبه ملفات إكسل لكنها أسرع وأقوى بكثير. وبفضلها تستطيع فرز البيانات وتصفيتها وتجميعها وحساب المتوسطات والإحصاءات في أسطر قليلة. ولذلك تعتبر المكتبة الأهم لكل من يتعامل مع تقارير السيو الضخمة أو ملفات الكلمات المفتاحية.
وفي مجال السيو تستخدم Pandas لقراءة ملفات CSV المصدرة من أدوات الكلمات المفتاحية أو من Search Console، ثم دمجها مع نتائج الزحف في جدول واحد. كما تتيح إزالة التكرار وحساب طول العناوين وتجميع الصفحات حسب القسم أو نوع المحتوى. ومن ثم يمكنك الإجابة عن أسئلة معقدة مثل أي الأقسام يحقق أعلى ظهور وأقل نقرات خلال دقائق.
وهذا مثال يقرأ ملفا ويحسب طول كل عنوان ثم يعرض العناوين الطويلة:
import pandas as pd

df = pd.read_csv("pages.csv")
df["title_length"] = df["title"].str.len()

long_titles = df[df["title_length"] > 60]
print(long_titles[["url", "title", "title_length"]])
ويوضح المثال كيف تتحول مشكلة تحتاج ساعات يدوية إلى نتيجة جاهزة في ثوان معدودة.
مكتبة Advertools لتحليل بيانات تحسين محركات البحث
صممت مكتبة Advertools خصيصا لخدمة المسوقين ومختصي السيو، وتجمع أدوات جاهزة لمهام شائعة مثل زحف المواقع (Crawling) وتحليل ملفات Sitemap وملفات robots.txt وتحليل عناوين URL. وتكمن قيمتها في أنها توفر عليك كتابة الكود من الصفر لمهام متكررة، فتحصل على نتائج منظمة في صورة جداول جاهزة للتحليل مباشرة بواسطة Pandas.
ومن أبرز إمكاناتها مع استخدام بايثون في تحسين محركات البحث زحف موقع كامل وحفظ نتائجه في ملف، ثم قراءة هذا الملف وتحليل العناوين والأوصاف والروابط ورموز الاستجابة. كما تدعم تحليل خرائط الموقع (Sitemaps) لاكتشاف الصفحات الموجودة فيها، إضافة إلى أدوات لتحليل هيكلة عناوين URL والكلمات الواردة فيها. وبالتالي تناسب الأداة المواقع المتوسطة والكبيرة التي يصعب فحصها بسكربتات بسيطة.
وفيما يلي مثال لزحف موقع وحفظ النتائج، ثم قراءتها بواسطة Pandas:
import advertools as adv
import pandas as pd

adv.crawl("https://example.com", "site_crawl.jl", follow_links=True)

crawl_df = pd.read_json("site_crawl.jl", lines=True)
print(crawl_df[["url", "title", "status"]].head())
ويمنحك هذا المثال أساسا قويا لأي تدقيق شامل، ويمكنك البناء عليه بإضافة الفلاتر والتقارير التي تناسب مشروعك.
واجهة Google Search Console API لتحليل أداء البحث
تتيح واجهة Search Console API سحب بيانات الأداء مباشرة من حسابك داخل Google بدلا من تصديرها يدويا، فتحصل على النقرات ومرات الظهور ومعدل النقر والمتوسط الترتيبي مقسمة حسب الاستعلام والصفحة والدولة والجهاز والتاريخ. وهذه البيانات هي المصدر الأدق لفهم سلوك موقعك في نتائج البحث، لأنها صادرة من محرك البحث نفسه وليست تقديرات من أدوات خارجية. ويمكنك مراجعة توثيق الواجهة الرسمي لمعرفة طريقة الاستخدام.
ويتطلب استخدام الواجهة إعداد مشروع في Google Cloud وتفعيل الخدمة وإنشاء بيانات اعتماد (Credentials) تسمح للسكربت بالوصول إلى حسابك. ورغم أن الإعداد الأولي يحتاج إلى بعض الصبر، فإنه يتم مرة واحدة فقط، وبعدها يمكنك سحب البيانات متى شئت. كما تسمح الواجهة بسحب عدد أكبر من الصفوف مقارنة بالتصدير اليدوي من واجهة الموقع، وهو ما يفيد المواقع الكبيرة تحديدا.
ومن الناحية العملية، تدمج بيانات الواجهة عادة مع Pandas لبناء تقارير مخصصة، مثل رصد الصفحات المتراجعة، أو اكتشاف الكلمات القريبة من الصفحة الأولى، أو مقارنة الأداء بين فترتين زمنيتين. ولا ننسى أن هذه البيانات تبقى سرية وحساسة، لذلك احرص على حماية ملفات الاعتماد وعدم مشاركتها علنا. وبهذا يصبح لديك مصدر بيانات موثوق تبني عليه قراراتك التحسينية بثقة.
كيفية استخدام بايثون في تحسين محركات البحث خطوة بخطوة
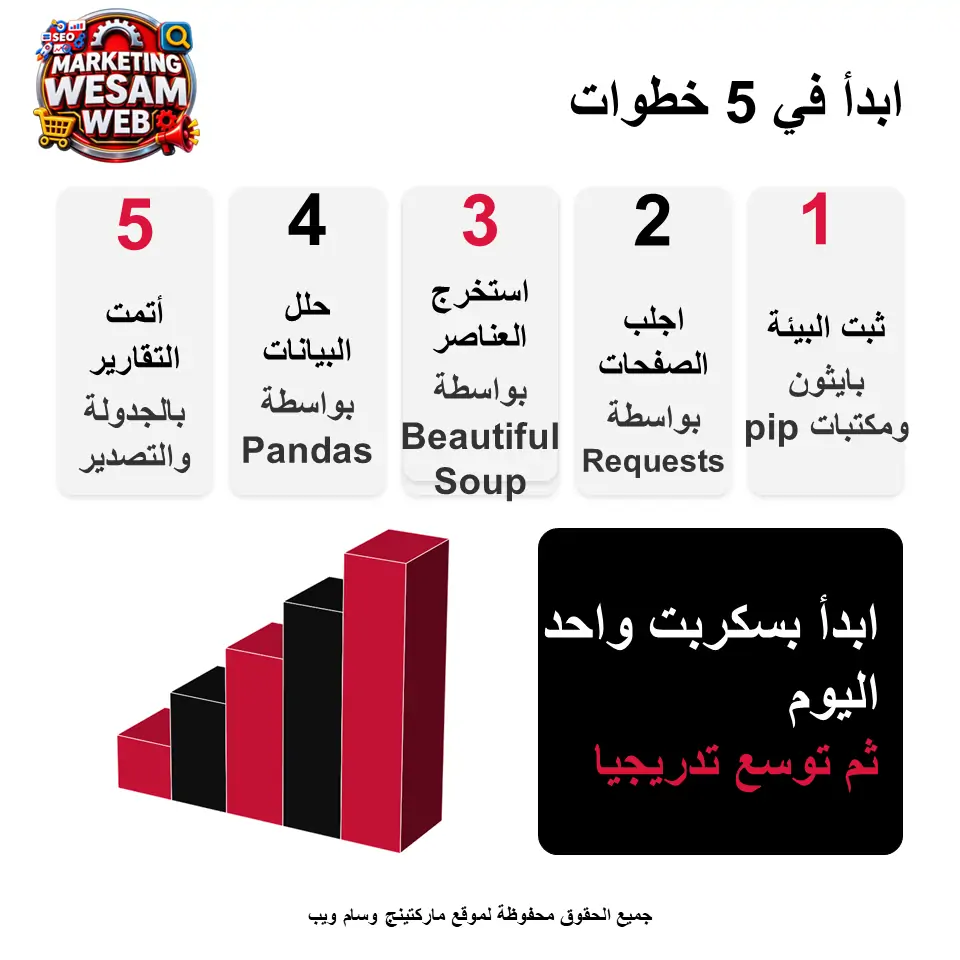
بعد أن تعرفنا على المكتبات الأساسية، حان الوقت للانتقال من النظرية إلى تطبيق استخدام بايثون في تحسين محركات البحث العملي، فالمعرفة لا تكتمل إلا بالتجربة. ويقوم المسار العملي على تسلسل منطقي يبدأ بتجهيز البيئة ثم جلب البيانات وتحليلها وانتهاء بتحليل الأداء من Search Console. ولا تقلق إذا كنت مبتدئا، فكل مثال هنا قصير وقابل للنسخ والتجربة مباشرة مع تعديل الروابط بما يناسب موقعك.
وتتلخص مراحل العمل في النقاط التالية، وسنشرح كل مرحلة بالتفصيل مع الكود:
- إعداد البيئة: تثبيت بايثون والمكتبات المطلوبة.
- جلب الصفحات: إرسال الطلبات وقراءة رموز الاستجابة.
- استخراج العناصر: جمع العناوين والأوصاف من الصفحات.
- تحليل الكلمات: قراءة ملفات CSV وترتيب الفرص.
- فحص الروابط: اكتشاف الصفحات المعطلة آليا.
- تحليل الأداء: ربط البيانات بـ Google Search Console.
إعداد بيئة بايثون وتثبيت المكتبات المطلوبة
تبدأ الرحلة بتحميل أحدث إصدار مستقر من بايثون من الموقع الرسمي وتثبيته على جهازك، ويفضل اختيار الخيار الذي يضيف بايثون إلى مسار النظام (PATH) أثناء التثبيت. وبعد ذلك يمكنك اختيار محرر الأكواد الذي يناسبك، مثل Visual Studio Code أو بيئة Jupyter Notebook التي تعد مناسبة جدا للمبتدئين لأنها تعرض النتائج مباشرة أسفل كل خطوة.
والخطوة التالية هي إنشاء بيئة افتراضية (Virtual Environment) لكل مشروع، وهي ممارسة احترافية تعزل مكتبات المشروع عن بقية جهازك وتمنع تعارض الإصدارات. ثم تثبت المكتبات المطلوبة بأمر واحد من سطر الأوامر باستخدام أداة pip، وهي الأداة الرسمية لإدارة حزم بايثون. وبهذه الطريقة تضمن بيئة نظيفة ومنظمة يسهل نقلها أو إعادة إنشائها لاحقا.
ويوضح الكود التالي أوامر الإعداد الأساسية لمعظم أنظمة التشغيل:
python -m venv seo-env
source seo-env/bin/activate   # على ويندوز: seo-env\Scripts\activate
pip install requests beautifulsoup4 pandas advertools
وبعد تنفيذ هذه الأوامر تصبح جاهزا للبدء في كتابة أول سكربت، ويمكنك التأكد من نجاح التثبيت باستيراد المكتبات داخل بايثون دون ظهور أي أخطاء.
جلب بيانات صفحات الويب باستخدام بايثون
تبدأ عملية الجلب بإرسال طلب GET إلى الرابط المطلوب ثم فحص رمز الاستجابة قبل أي معالجة، فالرمز 200 يعني أن الصفحة تعمل بشكل طبيعي. أما الرموز مثل 404 و500 فتعني وجود مشكلة تستحق التسجيل والمراجعة. ومن الأفضل دائما التعامل مع الأخطاء المحتملة بواسطة try و except حتى لا يتوقف السكربت عند أول رابط لا يستجيب.
وعند العمل على عدد كبير من الصفحات، احرص على تحديد فاصل زمني بين الطلبات لتجنب إرهاق الخادم، واحفظ النتائج في قائمة لمعالجتها لاحقا. وبذلك تحصل على أساس متين لبقية التحليلات، لأن جودة نتائجك تعتمد أساسا على سلامة البيانات التي تجلبها في هذه المرحلة.
import requests
import time

urls = ["https://example.com", "https://example.com/about"]
results = []

for url in urls:
    try:
        r = requests.get(url, timeout=10)
        results.append({"url": url, "status": r.status_code, "html": r.text})
    except requests.RequestException as e:
        results.append({"url": url, "status": "error", "html": ""})
    time.sleep(1)  # فاصل زمني بين الطلبات

print([(x["url"], x["status"]) for x in results])
استخراج عناوين الصفحات والأوصاف التعريفية
تعد عناوين الصفحات (Title Tags) والأوصاف التعريفية (Meta Descriptions) من أهم العناصر التي تظهر للمستخدم في نتائج البحث، ولذلك فإن مراجعتها بصورة دورية خطوة أساسية في أي تدقيق سيو. ويمكنك باستخدام Beautiful Soup استخراج هذه العناصر من كل صفحة وحساب طولها لاكتشاف العناوين الطويلة جدا أو الأوصاف الناقصة أو المفقودة تماما.
كما يمكنك استخراج وسوم H1 والتأكد من أن لكل صفحة عنوانا رئيسيا واحدا واضحا يعبر عن موضوعها. وبعد جمع هذه البيانات يمكن تصديرها إلى جدول، فتتحول إلى قائمة مهام جاهزة للفريق التحريري. ويفيد هذا الأسلوب بصورة خاصة في مواقع التجارة الإلكترونية التي تضم آلاف الصفحات المتشابهة.
from bs4 import BeautifulSoup
import pandas as pd

rows = []
for item in results:
    soup = BeautifulSoup(item["html"], "html.parser")
    title = soup.title.string.strip() if soup.title and soup.title.string else ""
    meta = soup.find("meta", attrs={"name": "description"})
    desc = meta["content"].strip() if meta and meta.get("content") else ""
    h1 = soup.h1.get_text(strip=True) if soup.h1 else ""
    rows.append({"url": item["url"], "title": title, "description": desc, "h1": h1,
                 "title_len": len(title), "desc_len": len(desc)})

df = pd.DataFrame(rows)
df.to_csv("onpage_audit.csv", index=False, encoding="utf-8-sig")
تحليل الكلمات المفتاحية باستخدام ملفات CSV
توفر معظم أدوات الكلمات المفتاحية إمكانية تصدير النتائج بصيغة CSV، وهي صيغة يقرؤها بايثون بسهولة تامة. وبعد قراءة الملف يمكنك ترتيب الكلمات حسب حجم البحث أو الصعوبة، وتصفية الكلمات التي تحتوي على عبارات معينة، وحساب عدد الكلمات في كل عبارة لاكتشاف الكلمات الطويلة التي تعكس نية بحث أكثر تحديدا.
ومن المفيد أيضا تصنيف الكلمات تلقائيا بحسب كلمات دالة، كأن تضع كل عبارة تحتوي على كلمة سعر في مجموعة النية التجارية، وكل عبارة تحتوي على كلمة كيف في مجموعة النية المعرفية. وبهذه الطريقة تبني خريطة محتوى منظمة تخدم الصفحات الصحيحة وتتفادى التكرار وحشو الكلمات المفتاحية والتضارب بين المقالات.
import pandas as pd

kw = pd.read_csv("keywords.csv")  # الأعمدة: keyword, volume, difficulty
kw["words"] = kw["keyword"].str.split().str.len()

def intent(k):
    if any(w in k for w in ["كيف", "ما هو", "شرح"]):
        return "informational"
    if any(w in k for w in ["سعر", "شراء", "أفضل"]):
        return "commercial"
    return "other"

kw["intent"] = kw["keyword"].apply(intent)
opportunities = kw[(kw["volume"] > 100) & (kw["difficulty"] < 40)].sort_values("volume", ascending=False)
print(opportunities.head(20))
فحص الروابط المعطلة باستخدام سكربت بايثون
يقوم هذا السكربت بقراءة قائمة الروابط من ملف أو من نتائج الزحف، ثم يزور كل رابط ويسجل رمز استجابته، ليخرج في النهاية بقائمة الروابط المعطلة فقط. ويفضل استخدام الطلب من النوع HEAD لتقليل حجم البيانات المنقولة، مع الرجوع إلى GET عند فشله لأن بعض الخوادم لا تدعم HEAD بصورة صحيحة.
وبعد الحصول على القائمة، قم بتصنيف الأخطاء إلى روابط داخلية تحتاج إلى إصلاح أو إعادة توجيه، وروابط خارجية تحتاج إلى استبدال أو حذف. وبهذا الأسلوب تحافظ على جودة تجربة المستخدم وتحمي ميزانية الزحف من الهدر في صفحات لا قيمة لها.
import requests

def check(url):
    try:
        r = requests.head(url, allow_redirects=True, timeout=10)
        if r.status_code in (405, 403):
            r = requests.get(url, timeout=10)
        return r.status_code
    except requests.RequestException:
        return "error"

links = ["https://example.com/page-1", "https://example.com/old-page"]
broken = [(u, check(u)) for u in links if check(u) not in (200, 301, 302)]
print(broken)
تحليل بيانات Google Search Console باستخدام بايثون
يمكنك تحليل بيانات Search Console بطريقتين، الأولى قراءة ملف CSV مصدر من الواجهة، والثانية الاتصال المباشر بالواجهة البرمجية لسحب بيانات أكبر وأحدث. وتناسب الطريقة الأولى المبتدئين لأنها لا تحتاج إلى إعداد معقد، بينما تناسب الثانية المواقع الكبيرة والتقارير الدورية التي تتطلب أتمتة كاملة.
وبعد الحصول على البيانات يمكنك البحث عن الفرص السريعة، وهي الصفحات التي يتراوح ترتيبها بين المركز الرابع والعشرين مع ظهور مرتفع ونقرات قليلة. وتعتبر هذه الصفحات أسهل الأهداف لتحقيق مكاسب سريعة، لأنها قريبة من الصفحة الأولى وتحتاج غالبا إلى تحسين العنوان أو إثراء المحتوى أو دعمها بروابط داخلية.
import pandas as pd

gsc = pd.read_csv("gsc_queries.csv")  # الأعمدة: query, page, clicks, impressions, ctr, position
quick_wins = gsc[(gsc["position"].between(4, 20)) & (gsc["impressions"] > 500) & (gsc["clicks"] < 20)]
quick_wins = quick_wins.sort_values("impressions", ascending=False)
print(quick_wins.head(15))
كيف تستخدم بايثون في تحسين محركات البحث التقني (Technical SEO)؟
يمثل السيو التقني (Technical SEO) المجال الأكثر استفادة من بايثون، لأن مشكلاته متكررة وقابلة للقياس ويمكن اكتشافها بقواعد واضحة تنفذها السكربتات بدقة. فسواء كان الأمر يتعلق بالزحف أو الفهرسة أو بنية الروابط أو سرعة الاستجابة، يستطيع السكربت فحص آلاف الصفحات وتقديم نتائج منظمة. ومن أبرز المشكلات التي يمكنك اكتشافها آليا ما يلي:
- أخطاء الصفحات مثل 404 وأخطاء الخادم 5xx.
- سلاسل إعادة التوجيه التي تبطئ الزحف وتضعف الروابط.
- العناوين والأوصاف المكررة بين الصفحات المختلفة.
- الصفحات اليتيمة التي لا تتلقى أي رابط داخلي.
- عناوين URL المشكلة مثل الطويلة جدا أو التي تحتوي معاملات زائدة.
- الصفحات المفقودة من Sitemap أو الموجودة فيه دون أن تكون صالحة للفهرسة.
فحص رموز استجابة HTTP وأخطاء الصفحات
تخبر رموز استجابة HTTP محركات البحث والمستخدمين بحالة كل صفحة، فالرمز 200 يعني النجاح، والرمز 301 يعني نقلا دائما، والرمز 404 يعني أن الصفحة غير موجودة، بينما تدل رموز 5xx على مشكلات في الخادم. ولذلك فإن فحص هذه الرموز بصورة دورية ضرورة لحماية الموقع من هدر ميزانية الزحف وفقدان الزوار، ويمكن تنفيذه بسهولة على قائمة روابط ضخمة.
ويمكنك تسريع الفحص عبر تنفيذ عدة طلبات بالتوازي باستخدام مكتبة concurrent.futures مع الحفاظ على عدد معقول من الطلبات المتزامنة. وبعد انتهاء الفحص يمكنك تجميع النتائج حسب الرمز لمعرفة حجم كل مشكلة. وبذلك تحدد أولوياتك بدقة، فتبدأ بأخطاء الخادم ثم أخطاء 404 على الصفحات المهمة ثم سلاسل التوجيه.
import requests
import pandas as pd
from concurrent.futures import ThreadPoolExecutor

def get_status(url):
    try:
        r = requests.get(url, timeout=10, allow_redirects=False)
        return {"url": url, "status": r.status_code, "redirect_to": r.headers.get("Location", "")}
    except requests.RequestException:
        return {"url": url, "status": "error", "redirect_to": ""}

urls = pd.read_csv("urls.csv")["url"].tolist()
with ThreadPoolExecutor(max_workers=5) as ex:
    data = list(ex.map(get_status, urls))

report = pd.DataFrame(data)
print(report["status"].value_counts())
تحليل ملفات Sitemap وعناوين URL
يعد ملف Sitemap خريطة تساعد محركات البحث على اكتشاف صفحات موقعك، ويجب أن يحتوي على الصفحات المهمة والصالحة للفهرسة فقط. ويمكن لمكتبة Advertools تحويل الملف إلى جدول بأمر واحد، ثم تحليل عناوين URL الواردة فيه ومعرفة عددها وهيكلتها وتواريخ تعديلها. وهذا يكشف بسرعة الأخطاء الشائعة مثل وجود صفحات محذوفة أو مكررة داخل الخريطة.
وبعد تحويل الخريطة إلى جدول، يمكنك فحص رمز استجابة كل رابط فيها باستخدام السكربت السابق، فالروابط التي تعيد 404 أو 301 لا مكان لها داخل الخريطة. كما يمكنك تحليل بنية المسارات (Directories) لمعرفة توزيع المحتوى بين الأقسام. وبالتالي تحافظ على خريطة نظيفة ودقيقة تدعم الاكتشاف والفهرسة بكفاءة.
import advertools as adv

sitemap = adv.sitemap_to_df("https://example.com/sitemap.xml")
print(len(sitemap))

sitemap["section"] = sitemap["loc"].str.extract(r"https?://[^/]+/([^/]+)/")
print(sitemap["section"].value_counts().head(10))
اكتشاف مشكلات العناوين والأوصاف التعريفية المكررة
يؤدي تكرار العناوين والأوصاف إلى إرباك محركات البحث بشأن الصفحة الأنسب لكل استعلام، كما يضعف جاذبية النتيجة أمام المستخدم. ولهذا فإن اكتشاف التكرار من أولويات التدقيق التقني، خاصة في المواقع التي تولد صفحاتها آليا مثل المتاجر وصفحات التصنيفات. وتستطيع مكتبة Pandas كشف التكرار في سطر واحد بعد تجهيز بيانات الزحف.
ومن المهم أيضا تجميع الصفحات المكررة تحت العنوان نفسه لتعرف أيها يستحق البقاء وأيها يحتاج إلى تعديل أو دمج أو وسم canonical. كما يمكنك فحص الأوصاف الفارغة والأوصاف التي تتجاوز الطول المناسب. وهكذا تتحول القائمة الطويلة من الملاحظات إلى خطة عمل مرتبة يسهل تنفيذها على مراحل.
import pandas as pd

df = pd.read_csv("onpage_audit.csv")

dup_titles = df[df.duplicated("title", keep=False) & (df["title"] != "")]
dup_titles = dup_titles.sort_values("title")

missing_desc = df[df["description"] == ""]
print(len(dup_titles), "duplicate titles |", len(missing_desc), "missing descriptions")
dup_titles.to_csv("duplicate_titles.csv", index=False, encoding="utf-8-sig")
تحليل الروابط الداخلية وتحديد الصفحات اليتيمة
تعرف الصفحة اليتيمة بأنها صفحة موجودة في الموقع أو في خريطة Sitemap لكنها لا تتلقى أي رابط داخلي من بقية الصفحات، فلا يستطيع الزاحف الوصول إليها بسهولة ولا ينتقل إليها أي ثقل. ويمكن اكتشاف هذه الصفحات بمقارنة قائمة الصفحات في الخريطة بقائمة الصفحات التي ظهرت كوجهة لروابط داخلية أثناء الزحف.
وبعد تحديد الصفحات اليتيمة، قرر هل تستحق الدعم بروابط داخلية من مقالات ذات صلة، أم أنها صفحات قديمة يفضل دمجها أو حذفها أو إعادة توجيهها. وبهذا الأسلوب تحول الصفحات المهملة إلى أصول قيمة تخدم الظهور والترتيب، وتعزز هيكل الموقع بصورة منظمة.
import advertools as adv
import pandas as pd

sitemap_urls = set(adv.sitemap_to_df("https://example.com/sitemap.xml")["loc"])

crawl = pd.read_json("site_crawl.jl", lines=True)
linked = set()
for links in crawl["links_url"].dropna():
    linked.update(links.split("@@"))

orphans = sorted(sitemap_urls - linked)
print(len(orphans), "orphan pages")
print(orphans[:20])
استخدام بايثون في تحسين محركات البحث في تحليل بيانات زحف المواقع
زحف المواقع (Website Crawling) هو العملية التي يتتبع فيها برنامج ما روابط الموقع صفحة بعد صفحة، ويجمع عنها بيانات مثل العناوين ورموز الاستجابة والروابط والوسوم الفنية. وتستطيع أدوات بايثون تنفيذ هذا الزحف بنفسها، لتحصل على قاعدة بيانات كاملة عن موقعك يمكن تحليلها كما تشاء بدلا من الاكتفاء بتقارير الأدوات الجاهزة وحدودها.
وتكمن قوة تحليل بيانات الزحف في قدرتها على كشف ما لا يظهر للعين المجردة، مثل الأقسام التي تستهلك نصيبا كبيرا من الزحف دون قيمة، أو الصفحات المهمة التي تقع في عمق كبير. ومن ثم يمكنك اتخاذ قرارات مبنية على صورة شاملة لبنية الموقع وليس على انطباعات جزئية.
كما أن حفظ بيانات الزحف في ملفات يتيح مقارنة الحالة قبل التعديلات وبعدها، فتقيس أثر أي إصلاح أو إعادة هيكلة بصورة دقيقة. وبالتالي يتحول الزحف من إجراء تقني معزول إلى أداة قياس مستمرة تدعم الاستراتيجية العامة لتحسين محركات البحث، وتمنحك دليلا ملموسا تعرضه على العملاء أو الإدارة.
تحليل ملفات الزحف واكتشاف مشكلات الصفحات
بعد إنجاز الزحف تحصل على ملف يضم صفا لكل صفحة وأعمدة لكل خاصية، ويمكن قراءته بواسطة Pandas وتلخيص حالته سريعا. فمن خلاله تعرف عدد الصفحات حسب رمز الاستجابة، والصفحات التي لا تحمل عنوانا، وتلك التي تعيد توجيه المستخدم، وتلك التي تحمل وسم noindex عن قصد أو عن غير قصد.
ويفيدك التلخيص في تحديد المشكلات الأكثر انتشارا أولا، ثم الغوص في تفاصيل كل منها. وينصح بحفظ ملف منفصل لكل نوع من المشكلات يسلم إلى الفريق المعني، سواء كان فريق المطورين أو فريق المحتوى. وبذلك تضمن توزيعا واضحا للمسؤوليات وتسريعا لعملية الإصلاح.
import pandas as pd

crawl = pd.read_json("site_crawl.jl", lines=True)

print(crawl["status"].value_counts())

no_title = crawl[crawl["title"].isna()][["url", "status"]]
redirects = crawl[crawl["status"].isin([301, 302])][["url", "status"]]

no_title.to_csv("no_title.csv", index=False)
redirects.to_csv("redirects.csv", index=False)
تحديد الصفحات التي تعاني من ضعف الروابط الداخلية
تحتاج الصفحة المهمة إلى عدد كاف من الروابط الداخلية القادمة من صفحات ذات صلة ليدرك محرك البحث أهميتها. ويمكنك من بيانات الزحف حساب عدد الروابط الواردة لكل صفحة وترتيب الصفحات تصاعديا، فتظهر لك الصفحات الأضعف دعما. ثم قارن هذه القائمة بقائمة صفحاتك الاستراتيجية لتعرف أيها يحتاج إلى دعم عاجل.
وبعد تحديد الصفحات الضعيفة، ابحث عن مقالات قوية وذات صلة يمكنها منحها روابط طبيعية بنصوص وصفية. ويستحسن ألا يكون الربط عشوائيا، بل مبنيا على التقارب الموضوعي بين الصفحتين. وبهذه الطريقة ترفع قوة الصفحات المستهدفة تدريجيا وتحسن تجربة التنقل، وتدعم ظهورها في نتائج البحث دون تكلفة إضافية.
import pandas as pd

crawl = pd.read_json("site_crawl.jl", lines=True)

edges = crawl[["url", "links_url"]].dropna().copy()
edges["target"] = edges["links_url"].str.split("@@")
edges = edges.explode("target")

inlinks = edges[edges["url"] != edges["target"]]["target"].value_counts()
weak = inlinks[inlinks < 3]
print(weak.head(20))
تحليل محتوى صفحات الويب باستخدام بايثون في تحسين محركات البحث
لا يقتصر استخدام بايثون في تحسين محركات البحث على الجانب التقني، فهي أداة فعالة أيضا في تحليل المحتوى، إذ تساعدك على مقارنة مقالاتك بمقالات المنافسين، واكتشاف الصفحات الضعيفة أو المتشابهة، وتحديد الفرص التي يمكن أن تحول محتواك من متوسط إلى متميز. وفي هذا القسم ننتقل من فحص الشيفرة إلى فحص جودة النص وتنوعه بأسلوب عملي.
حساب عدد الكلمات ومقارنة أطوال المقالات
يعد عدد الكلمات مؤشرا مساعدا لقياس عمق التغطية، وليس عاملا مباشرا في الترتيب، لكنه يكشف الصفحات الخفيفة جدا التي قد لا تلبي نية البحث. ويمكنك باستخدام Beautiful Soup استخراج نص المقال وحساب عدد كلماته، ثم مقارنته بمتوسط المقالات المنافسة على الاستعلام نفسه لمعرفة حجم الفجوة المحتملة.
ومن الضروري ألا تجعل الطول هدفا في ذاته، فجودة المعلومات وتنظيمها وملاءمتها لنية الباحث أهم من عدد الكلمات. لذلك استخدم هذه المقارنة كإشارة أولية تدفعك إلى مراجعة الصفحات الضعيفة، ثم قيم المحتوى بعين بشرية. وهكذا توازن بين التحليل الكمي والحكم التحريري، وتتجنب الحشو الذي يضر بتجربة القارئ.
import requests
from bs4 import BeautifulSoup

def word_count(url):
    html = requests.get(url, timeout=10).text
    soup = BeautifulSoup(html, "html.parser")
    for tag in soup(["script", "style", "nav", "footer"]):
        tag.decompose()
    return len(soup.get_text(separator=" ").split())

mine = word_count("https://example.com/my-article")
competitors = [word_count(u) for u in ["https://example.org/a", "https://example.net/b"]]
print(mine, sum(competitors) / len(competitors))
اكتشاف الصفحات المتشابهة وفرص تحسين المحتوى
يحدث تشابه المحتوى عندما تتناول صفحتان أو أكثر الموضوع نفسه بصياغات متقاربة، مما يؤدي إلى تنافس داخلي (Cannibalization) يضعف ترتيب كليهما. ويمكن اكتشاف هذه الحالات بتحويل النصوص إلى متجهات باستخدام تقنية TF-IDF ثم حساب درجة التشابه بين كل صفحتين بمكتبة scikit-learn. والصفحات التي تتجاوز درجتها حدا معينا تستحق المراجعة.
وبعد اكتشاف الصفحات المتشابهة، يمكنك دمجها في صفحة أقوى أو تمييز كل صفحة بزاوية ونية بحث مختلفة، أو استخدام وسم canonical عند الحاجة. كما تفيد النتائج في العثور على فرص لتوسيع المحتوى. وبهذه الخطوات تبني هيكلا نظيفا للمحتوى يخدم كل صفحة هدفا واضحا ومستقلا.
# pip install scikit-learn
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
import pandas as pd

pages = pd.read_csv("pages_text.csv")  # الأعمدة: url, text
vec = TfidfVectorizer(max_features=5000)
matrix = vec.fit_transform(pages["text"])
sim = cosine_similarity(matrix)

pairs = []
for i in range(len(pages)):
    for j in range(i + 1, len(pages)):
        if sim[i][j] > 0.8:
            pairs.append((pages["url"][i], pages["url"][j], round(sim[i][j], 2)))
print(pairs)
أتمتة مهام تحسين محركات البحث باستخدام بايثون
تمثل الأتمتة (Automation) الثمرة الأهم لتعلم بايثون، لأنها تنقلك من تنفيذ المهام بنفسك كل مرة إلى بناء نظام يعمل نيابة عنك. فبعد أن تكتب السكربت وتختبره، يمكنك جدولته ليعمل في مواعيد ثابتة ويرسل لك النتائج جاهزة، مما يمنحك وقتا أكبر للتفكير والتخطيط. ومن أبرز المهام التي تستحق الأتمتة ما يلي:
- فحص رموز الاستجابة للصفحات المهمة يوميا.
- رصد الروابط المعطلة الجديدة أسبوعيا.
- سحب بيانات Search Console وتحديث التقارير تلقائيا.
- مراقبة العناوين والأوصاف للتأكد من عدم تغييرها بالخطأ.
- إرسال تنبيهات عند ظهور مشكلة حرجة في الموقع.
- تصدير التقارير بصيغة جاهزة للمشاركة مع الفريق والعملاء.
تشغيل عمليات تدقيق المواقع بصورة دورية
يمكنك جدولة السكربتات بطريقتين شائعتين، الأولى استخدام أدوات النظام مثل Cron على لينكس وماك أو Task Scheduler على ويندوز، والثانية استخدام مكتبة schedule داخل بايثون نفسها. وتناسب الطريقة الأولى الخوادم والمهام الدائمة، بينما تناسب الثانية التجارب السريعة والمشاريع الصغيرة. وفي الحالتين تأكد من تسجيل النتائج مع التاريخ لتتمكن من مقارنة الأداء عبر الزمن.
ومن الأفضل أن يتضمن السكربت آلية تنبيه بسيطة، كأن يرسل رسالة بريد أو إشعارا عند اكتشاف خطأ جديد في صفحة مهمة. وبذلك لا تنتظر موعد المراجعة اليدوية لتكتشف المشكلة، بل تعرف بها فور حدوثها وتتصرف سريعا. ويقلل هذا الأسلوب من مخاطر فقدان الزيارات بسبب أعطال لم يلاحظها أحد لأيام.
import schedule
import time
import requests

important_pages = ["https://example.com/", "https://example.com/services"]

def daily_audit():
    for url in important_pages:
        status = requests.get(url, timeout=10).status_code
        if status != 200:
            print(f"ALERT: {url} returned {status}")  # استبدلها بإرسال بريد أو إشعار

schedule.every().day.at("08:00").do(daily_audit)

while True:
    schedule.run_pending()
    time.sleep(60)
تصدير تقارير SEO إلى ملفات CSV وتحليلها
يعد تصدير النتائج إلى ملفات CSV الخطوة الختامية لأي سكربت تدقيق، فهذه الصيغة يفتحها إكسل وجداول Google وأغلب أدوات التقارير بسهولة. ويمكنك تسمية الملفات بتاريخ التشغيل لتكوين أرشيف يسمح بمقارنة نتائج اليوم بنتائج الشهر الماضي. ومن المهم استخدام ترميز utf-8-sig عند التعامل مع النصوص العربية لتظهر بصورة صحيحة داخل إكسل.
وبعد التصدير يمكنك تحليل التغيرات بين تقريرين لمعرفة المشكلات التي أصلحتها وتلك التي ظهرت حديثا. وهذا النوع من المقارنة يمنحك دليلا ملموسا على أثر عملك، ويسهل عرض النتائج على العملاء أو الإدارة بلغة الأرقام. وهكذا تتحول بياناتك إلى قصة نجاح موثقة وليست مجرد ملفات متراكمة.
import pandas as pd
from datetime import date

report = pd.DataFrame(data)  # نتائج الفحص من الأقسام السابقة
filename = f"seo_report_{date.today()}.csv"
report.to_csv(filename, index=False, encoding="utf-8-sig")

# مقارنة مع تقرير سابق
old = pd.read_csv("seo_report_2026-09-29.csv")
new = pd.read_csv(filename)
new_errors = new[(new["status"] != 200) & (~new["url"].isin(old[old["status"] != 200]["url"]))]
print(new_errors)
ما الفرق بين استخدام بايثون في تحسين محركات البحث وأدوات تحسين محركات البحث الجاهزة؟
لا تمثل بايثون بديلا كاملا لأدوات السيو الجاهزة، ولا تقل الأدوات الجاهزة أهمية في كثير من الحالات، فكل منهما يخدم احتياجا مختلفا. فالأدوات الجاهزة تقدم واجهات سهلة وبيانات جاهزة مثل قواعد الروابط الخلفية وتقديرات حجم البحث دون الحاجة إلى برمجة، وهو ما يناسب الفرق التي تريد نتائج سريعة. في المقابل، تمنحك بايثون حرية كاملة في تصميم الفحوص وتحليل البيانات بطريقتك الخاصة.
والنهج الأمثل عمليا هو الجمع بين الأسلوبين، فتستخدم الأدوات الجاهزة للحصول على بيانات لا يمكنك جمعها بنفسك، وتستخدم بايثون لمعالجتها ودمجها وأتمتتها. وبذلك تستفيد من قوة البيانات الجاهزة ومرونة البرمجة معا. ويوضح الجدول التالي أبرز الفروقات بين الطريقتين:
| وجه المقارنة | بايثون | الأدوات الجاهزة |
|---|---|---|
| التكلفة | مجانية غالبا | اشتراكات شهرية في الغالب |
| سهولة البدء | تحتاج تعلما أوليا | سهلة وجاهزة فورا |
| المرونة | عالية جدا وقابلة للتخصيص | محدودة بإمكانات الأداة |
| الأتمتة | كاملة بحسب رغبتك | محدودة غالبا |
| حجم البيانات | حسب إمكانات جهازك | حسب حدود الباقة |
| بيانات الروابط والمنافسين | تحتاج مصدرا خارجيا | متوفرة غالبا |
| التقارير | مخصصة بالكامل | قوالب جاهزة |
ما حدود استخدام بايثون في تحسين محركات البحث؟
رغم المزايا الكبيرة، فإن لاستخدام بايثون حدودا يجب أن يعرفها كل مختص بوضوح كي لا تتحول الأداة إلى مصدر وهم. فبايثون لا ترفع الترتيب بذاتها، وإنما تكشف المشكلات والفرص وتسرع التنفيذ، أما التحسين الفعلي فيعتمد على جودة المحتوى وسلامة الموقع وتجربة المستخدم. كما أن بعض البيانات مثل الروابط الخلفية وتقديرات الزيارات لا يمكن جمعها بدقة دون مصادر متخصصة.
ومن الحدود المهمة أيضا الجانب القانوني والأخلاقي لاستخراج البيانات، إذ يجب احترام ملف robots.txt وشروط استخدام المواقع، وتجنب الضغط الزائد على الخوادم. إضافة إلى ذلك تحتاج السكربتات إلى صيانة مستمرة لأن بنية المواقع تتغير، كما أن النتائج الآلية تتطلب مراجعة بشرية لأنها قد تخطئ في فهم السياق. وفيما يلي أبرز الحدود التي ينبغي وضعها في الحسبان:
- لا تغني عن الخبرة، فالأرقام تحتاج إلى تفسير سيو صحيح.
- تحتاج وقتا للتعلم في البداية، خاصة مع الأكواد المتقدمة.
- تتطلب صيانة عند تغير بنية المواقع أو واجهات البرمجة.
- تخضع لقيود الخوادم وسياسات المواقع في الزحف.
- لا توفر بيانات حصرية مثل الروابط الخلفية دون مصادر خارجية.
- قد تنتج نتائج غير دقيقة إذا كانت البيانات المدخلة ناقصة أو غير نظيفة.
الأسئلة الشائعة حول استخدام بايثون في تحسين محركات البحث
يطرح كثير من المبتدئين أسئلة متكررة قبل أن يبدؤوا رحلتهم مع بايثون والسيو، وهي أسئلة مشروعة تعكس رغبة صادقة في الفهم قبل الاستثمار في تعلم مهارة جديدة. ولذلك جمعنا لك في هذا القسم أكثر الأسئلة شيوعا مع إجابات واضحة ومختصرة تساعدك على اتخاذ خطوتك الأولى بثقة ووعي.
هل يجب تعلم البرمجة لاستخدام بايثون في تحسين محركات البحث؟
لا يشترط أن تصبح مبرمجا محترفا، لكن تحتاج إلى فهم أساسيات بايثون مثل المتغيرات والقوائم والحلقات والدوال وقراءة الملفات. وهذه الأساسيات يمكن تعلمها في أسابيع قليلة بالتدريب المنتظم. وبعدها تستطيع تعديل الأمثلة الجاهزة وتكييفها مع مشروعك، ثم تتدرج تدريجيا نحو بناء سكربتاتك الخاصة.
هل يمكن استخدام بايثون مجانا لتحليل المواقع؟
نعم، فلغة بايثون مجانية ومفتوحة المصدر، وكذلك أغلب مكتبات التحليل مثل Requests وBeautiful Soup وPandas وAdvertools. كما أن واجهة Search Console API متاحة دون رسوم ضمن حدود الاستخدام المقررة. وقد تحتاج فقط إلى دفع تكلفة الاستضافة أو الخوادم إذا أردت تشغيل السكربتات بصورة دائمة، أو إلى اشتراك في مصادر بيانات خارجية متخصصة.
هل تستطيع بايثون استخراج بيانات نتائج بحث Google؟
من الناحية التقنية يمكن كتابة سكربت يجلب صفحات نتائج البحث، لكن سياسات Google تقيد الاستخراج الآلي لصفحاتها، وقد يؤدي ذلك إلى حظر الطلبات. لذلك يفضل الاعتماد على المصادر الرسمية مثل Search Console API لبيانات موقعك، أو على مزودي بيانات مرخصين لمتابعة نتائج البحث. ويحميك هذا الأسلوب من المخاطر التقنية والقانونية ويضمن لك بيانات أكثر استقرارا.
هل تساعد بايثون في اكتشاف مشكلات SEO التقني؟
نعم، فهذا من أقوى استخداماتها، إذ يمكنها فحص رموز الاستجابة والروابط المعطلة وسلاسل التوجيه والعناوين المكررة والصفحات اليتيمة وخرائط Sitemap على نطاق واسع. ومع ذلك تبقى مراجعة النتائج بعين خبيرة ضرورية، لأن بعض الحالات تعد مقبولة في سياق معين. فالسكربت يكشف الظواهر، أما القرار النهائي فيعود إلى فهمك لطبيعة الموقع وأهدافه.
هل يمكن استخدام بايثون لتحليل بيانات Google Search Console؟
نعم، ويمكن ذلك بطريقتين، قراءة الملفات المصدرة من الواجهة، أو الاتصال بالواجهة البرمجية لسحب البيانات مباشرة. وتتيح لك البيانات المسحوبة اكتشاف الفرص القريبة من الصفحة الأولى، ورصد الصفحات المتراجعة، وتحليل الاستعلامات حسب الدولة والجهاز. ويعد هذا الاستخدام من أكثر الاستخدامات عائدا لأن البيانات صادرة من Google نفسها.
هل يؤدي استخدام بايثون إلى تحسين ترتيب الموقع مباشرة؟
لا، فبايثون أداة تحليل وأتمتة وليست عاملا من عوامل الترتيب. ويأتي التحسن في الترتيب من تنفيذ التوصيات التي تكشفها الأداة، مثل إصلاح الأخطاء وتحسين المحتوى وتقوية الروابط الداخلية. لذلك قد تستغرق النتائج وقتا حتى تظهر، كما تختلف من موقع إلى آخر بحسب المنافسة وجودة التنفيذ. والأهم أن تعامل بايثون بوصفها وسيلة لاتخاذ قرارات أفضل وبسرعة أكبر.
الخاتمة
يتضح مما سبق أن استخدام بايثون في تحسين محركات البحث ليس رفاهية تقنية، بل مهارة عملية تمنح المختص قدرة على فحص المواقع وتحليل البيانات وأتمتة المهام بدقة وسرعة يصعب تحقيقها يدويا. وقد استعرضنا في هذا الدليل المفهوم والأهمية والمهام، ثم الأدوات والمكتبات مع أمثلة كود عملية، وصولا إلى السيو التقني وتحليل الزحف والمحتوى وأتمتة التقارير.
ومن ناحية أخرى، تذكر أن بايثون أداة داعمة تعمل بجانب خبرتك في السيو وفهمك لنية الباحث وجودة المحتوى، وليست بديلا عنها. ولذلك ابدأ بخطوات صغيرة، كفحص رموز الاستجابة لموقعك أو استخراج العناوين والأوصاف، ثم توسع تدريجيا كلما اكتسبت ثقة أكبر. وبالتالي تبني مهارة متراكمة تزداد قيمتها مع الوقت، وتميزك في سوق يزداد اعتمادا على البيانات.
وأخيرا، نوصيك بمتابعة إرشادات محركات البحث الرسمية وتوثيق المكتبات باستمرار، فالمجال يتطور بسرعة، وما يصلح اليوم قد يحتاج إلى تحديث غدا. وإذا أعجبك هذا الدليل فتابع مقالاتنا القادمة في السيو والتسويق والتجارة الإلكترونية والذكاء الاصطناعي، حيث نقدم تطبيقات أعمق تخدم مشروعك. وابدأ الآن بتطبيق أول سكربت على موقعك، فالرحلة الطويلة تبدأ دائما بخطوة واحدة.